这是在巴黎 RAISE 峰会现场对 Together AI 高管的专访。过去一年,开放权重模型出现”踩踏式”涌入:Together 处理的开放模型 token 量增长一万倍,九个月前每月服务300亿 token,如今每月超过400万亿 token;公司完成8亿美元融资、收入同比增长10倍、收入突破10亿美元。访谈围绕开放权重相对闭源模型6到60倍的成本差、数据主权与IP控制、企业自建harness(智能协调回路)、零切换成本、欧洲主权技术栈,以及与 Vista Equity 合作把城市闲置电力改造为推理数据中心展开。
一、一年之变:开放权重成为Agentic AI的主力
主持人在巴黎 RAISE 峰会现场回顾去年对话时指出,去年讨论AI工厂、KV缓存、大规模系统时,开放权重的快速崛起根本不在雷达上。Together AI 高管回应,过去一年最显著的变化,是几乎出现了一场涌向开放权重模型的”踩踏”(stampede)。
他们服务并允许客户用自己的数据继续训练、适配这些开放权重模型。过去一年,经他们处理、流向开源模型的 token 数量增长了一万倍(10,000x)。开放权重模型已经在某种意义上成为 agentic AI 的”主力马”(workhorse),而这在一年前是完全不存在的局面。公司本身也完成了8亿美元融资,并已跨越10亿美元收入规模,资本充足,进入下一阶段增长。
二、开放权重为何重要:成本、控制、合规
主持人请嘉宾解释开放权重(open weights)到底是什么、为什么重要。嘉宾解释:开放权重就是模型本身作为一个文件发布,可以直接去 Hugging Face 下载。而运行这些模型本身很复杂,Together AI 这类平台的价值就是让企业把这些模型部署进生产环境变得极其简单。
开放权重重要有三个理由。第一是成本:对客户而言,开放权重模型与闭源权重模型之间的成本差达到6到60倍,在大规模部署AI时这是非常实质性的差距。第二是控制:这些模型可以运行在客户想要的计算环境里。例如 Together 现在在美国、欧洲、亚洲都提供开放基座模型,分别遵从当地的合规、数据法律与安全要求。第三是越来越多企业不愿把自己的专有数据送进一个训练闭源模型的公司,担心后者反过来在自己的业务上与自己竞争,这推动企业转向开放权重,以便掌握自己的IP。
三、token经济:从300亿到400万亿的月吞吐
主持人追问是否已经出现临界点。嘉宾给出两组硬数字:九个月前,Together 每月服务300亿(30 billion)token;如今每月服务超过400万亿(400 trillion)token。需求之旺盛堪称惊人。这背后是一种正在发生的巨大结构性转移,而他们正处在这场转移的中心。
在成本之外,嘉宾强调平台从控制、经济、延迟到容量都为服务开放权重与定制模型而专门设计。客户既可以直接选择开放模型,也可以用自己的数据继续训练(post-train),再由平台以客户自己难以达到的价格高效服务——因为让这一切高效需要大量软件与研究投入。
四、企业如何落地:数据、IP与多模型混搭
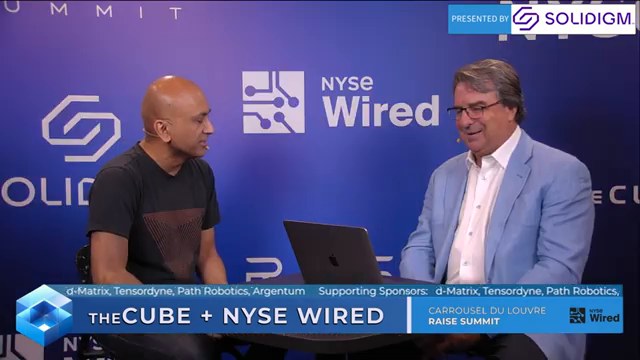
主持人代入一个典型企业决策者:我要保护自己的流程IP、工作流和数据,又想在可用时使用大模型,该怎么办?嘉宾的答案是:使用开放权重就是正确答案。你不会把数据分享给一家训练模型的公司,对数据驻留(data residency)和数据去向拥有完全控制,同时仍可以在自己的 harness 内混搭多个模型以取得最佳结果。
嘉宾进一步指出,这开始成为企业有效部署AI的一种模式:在加速生产流程、提升企业效率的同时,也创造出属于企业自己、可拥有的AI资产,这些资产成为企业知识产权的一部分。这已经不只是一个IT项目,而是商业模式的转型,而token本身就是这场经济中的货币与带宽。
五、业务进展:收入同比10倍增长
主持人问公司业务亮点。嘉宾表示业务表现极佳:收入同比增长10倍(10x year over year),需求极其旺盛。公司打造了一个真正为服务开放权重与定制模型而设计的平台,覆盖控制、经济、延迟、容量等全部所需功能,因此处在非常有利的位置。
嘉宾把这种需求描述为一场正在进行的巨大转移。平台面向AI原生、数字原生与企业三类用户,把开放权重模型的供给、定制与高效服务串成一体。
六、欧洲与主权技术栈:把价值留在本国
身在巴黎,主持人谈到欧洲人热爱主权(sovereignty),开放权重正好形成一场完美风暴:欧洲不仅想做隐私和数据留存,更想把钱留在本国。嘉宾认同:目标是注入智能(inject intelligence),而不是建造最好的流程;有了推理就有使用量,使用量就是价值与金钱。既然如此,法国为什么不想把这笔钱留在国内?
嘉宾特别提到法国本地可用的电力——这在世界多数地方并不具备。他认为这里掀起了一股从零搭建主权技术栈(sovereign stack)的热情,而且这会在全球范围内发生:AI会越来越多地在岸部署(onshore),因为它正成为类似劳动力市场的一部分,而企业希望对其拥有访问权与控制权。
七、闲置电力改造:Vista Equity合作与边缘推理数据中心
主持人谈到AI工厂正以最快速度建造,但开始出现更”强壮的边缘节点”(beefier edges),以及50MW、20MW这类分布式算力范式。嘉宾透露,Together 最近宣布与 Vista Equity 合作:把美国都市区里被闲置、搁浅的电力(stranded power)改造为他们计划运营的推理数据中心。
他打了个比方:一台停摆五年的印刷机,完全可以被改造为一个优秀的边缘推理数据中心。客户只需设计好架构,在大节点、工厂与中等强壮边缘之间按工作负载分配权重;平台把这些复杂性抽象掉,客户只是组合API、部署模型、选择区域,其余全部自动完成。
八、harness:智能、行动与代理的协调回路
主持人多次提到harness(承载/回路框架),并请嘉宾向不了解的听众解释。嘉宾解释:模型被设计为你给它一个prompt,它吐出答案,然后就结束。而 harness 是一个回路:它调用模型、规划下一步做什么,基于模型的判断使用工具采取行动,再回到模型,如此循环直到任务完成。
例如harness的输入是”修复我这套软件的安装”,harness就开始与模型对话、循环调用工具完成任务。本质上harness就是一个agent。企业正在把这些harness接上数据系统、权限系统、记录系统(log systems of record),把它们作为工具挂到harness上,MCP也在这一层发挥作用。
九、零切换成本:从闭源到开放或混合使用
嘉宾谈到过去一年另一项大创新就是harness。他把harness理解为对智能、行动与代理的协调,harness会多次调用模型来真正完成一个任务。以 Anthropic 的 Claude Code 为例,同时也有 Hermes、OpenClaw、OpenCode 这类开放harness被广泛使用。
关键在于:这些harness允许你通过替换成另一个API来更换底层模型,而切换成本几乎为零(almost zero)。当模型犯错时,harness可以回到模型,用略不同的方式重新提问来纠正错误。正因如此,许多公司正从闭源转向开放,或把两者混合使用;成本并不是唯一驱动,反锁定(anti-lock-in)保护、灵活性与速度同样重要,容量有时也很关键。
十、市场扩张:从AI原生到数字原生
主持人观察到市场正从AI原生产品扩张开来。嘉宾表示,数字原生(digital natives)已经是成熟的AI用户多年,开始把开放权重模型纳入自己的技术栈,自建harness、自建benchmark来比较结果,其中一些甚至组建AI研究团队、自己造模型。
而在企业侧,目前看到更多仍是部署AI原生产品,而非自己动手DIY。一个可见的趋势是:数字原生用户在自建harness与基准比较,企业则在更谨慎地把AI原生产品纳入流程,两条路线正在汇合。
十一、治理:代理继承权限的新命题
主持人反复强调治理(governance)在这一层仍然主导对话,因为在这一层可以落进安全、治理等第一性原理,这是一种新的”管道”(new layer plumbing)。嘉宾认同还有很多工作要做:如何接管现有的权限系统、认证系统,如何”授权”(bless)代理能够一致地使用它们。
他特别指出一个现实问题:工具已经变得如此强大,而这些工具未来将由代理(agent)运行,因此工具本身必须经过校验(validated),不能让工具被一个失控的代理(rogue agent)使用。今天常见的情况是代理代表用户工作,并继承该用户拥有的权限与访问;而企业真正想要的,是让代理在受控范围内更自主地行动,这正是新harness需要界定的范围。
十二、展望:核心基础设施与开放模型版图
谈到模型版图,嘉宾表示中国正涌现出一批非常优秀的前沿开放模型;上个月发布的 Nvidia Nemotron Ultra 也是令人兴奋的模型,Nvidia 还有很好的路线图,夏天还会有一批模型发布,开放模型的这个夏天相当令人期待。
访谈收尾,主持人总结AI基础设施仍是对话主导,数据中心正以最快速度建成、新晶圆厂在建,更多AI基础设施还在到来,而一切才刚刚开始。Together AI 自身聚焦增长,目标是成为AI原生、数字原生与企业的核心基础设施。